Έκθεμα 6.5
5Ευθυγράμμιση
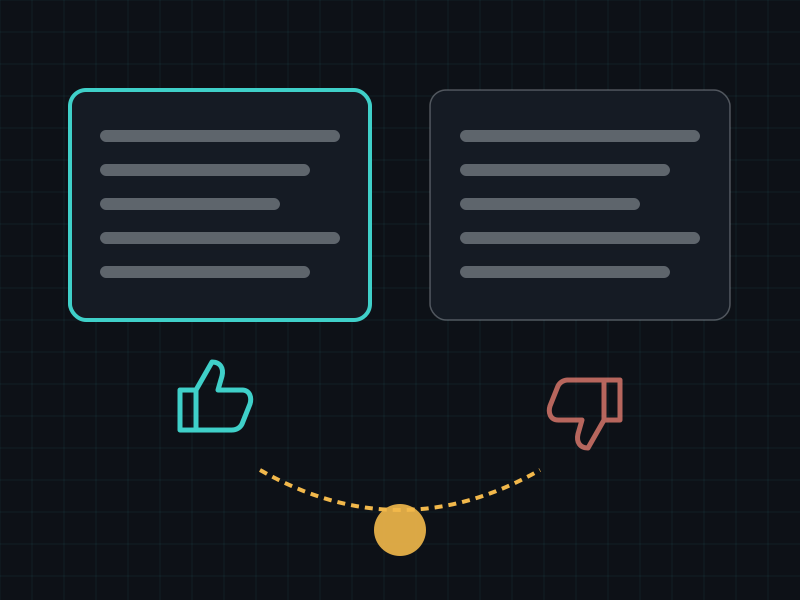
Άνθρωποι, ή και άλλα μοντέλα, αξιολογούν απαντήσεις. Το μοντέλο ενισχύεται προς τις πιο χρήσιμες, ειλικρινείς και ασφαλείς. Γνωστή τεχνική είναι η ενισχυτική μάθηση από ανθρώπινη ανατροφοδότηση (RLHF).
Γιατί βρίσκεται στο μουσείο
Ένα σύγχρονο γλωσσικό μοντέλο δεν εμφανίζεται έτοιμο. Περνά από δεδομένα, εκπαίδευση, προσαρμογή, αξιολόγηση και τελικά παραγωγή απάντησης.
Τι στηρίζει το έκθεμα
Πρωτογενής ερευνητική δημοσίευση
Τη χρήση ανθρώπινων προτιμήσεων και reinforcement learning για ευθυγράμμιση απαντήσεων.
Κύρια πηγή: Ouyang, L. et al. (2022), “Training language models to follow instructions with human feedback”.
Τι χρειάζεται προσοχή: Πρωτογενής πηγή · σήμερα χρησιμοποιούνται και άλλες μέθοδοι πέρα από RLHF
Ρώτησε το έκθεμα
Ο μικρός ξεναγός αυτής της σελίδας χρησιμοποιεί μόνο όσα υπάρχουν στον φάκελο του εκθέματος. Αν η ερώτηση ζητά κάτι που δεν τεκμηριώνεται εδώ, δεν θα το συμπληρώσει μόνος του.
Μπορείς να ξεκινήσεις με μία από τις ερωτήσεις που βλέπεις πιο πάνω.