Έκθεμα 6.2
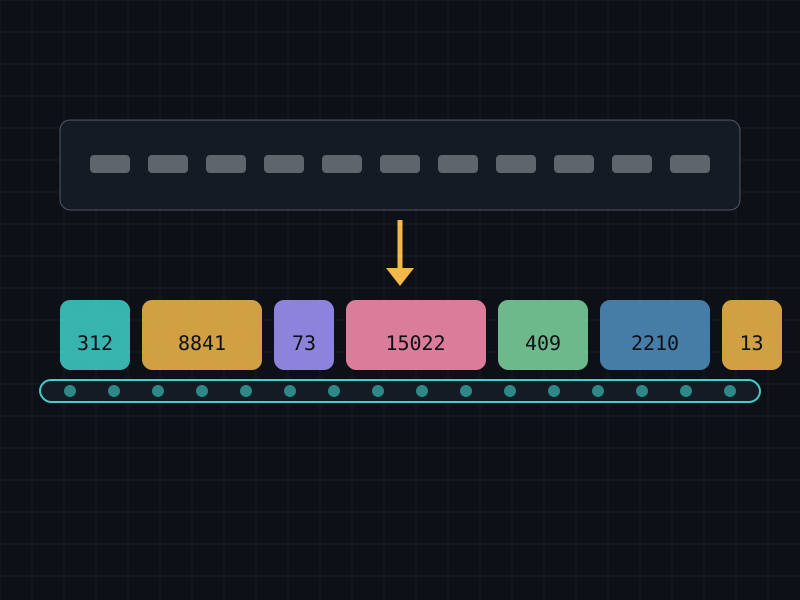
2Κομμάτιασμα σε tokens
Το κείμενο σπάει σε μικρά κομμάτια, τα tokens, που μπορεί να είναι ολόκληρες λέξεις ή μέρη λέξεων. Το μοντέλο βλέπει μόνο αριθμούς, όχι γράμματα.
Γιατί βρίσκεται στο μουσείο
Ένα σύγχρονο γλωσσικό μοντέλο δεν εμφανίζεται έτοιμο. Περνά από δεδομένα, εκπαίδευση, προσαρμογή, αξιολόγηση και τελικά παραγωγή απάντησης.
Τι στηρίζει το έκθεμα
Πρωτογενής ερευνητική δημοσίευση
Τη χρήση υπολεξικών μονάδων/BPE για αναπαράσταση σπάνιων ή άγνωστων λέξεων.
Κύρια πηγή: Sennrich, Haddow & Birch (2016), ACL, subword units.
Τι χρειάζεται προσοχή: Πρωτογενής πηγή · τα ακριβή tokenizers διαφέρουν ανά μοντέλο
Ρώτησε το έκθεμα
Ο μικρός ξεναγός αυτής της σελίδας χρησιμοποιεί μόνο όσα υπάρχουν στον φάκελο του εκθέματος. Αν η ερώτηση ζητά κάτι που δεν τεκμηριώνεται εδώ, δεν θα το συμπληρώσει μόνος του.
Μπορείς να ξεκινήσεις με μία από τις ερωτήσεις που βλέπεις πιο πάνω.